Warum bald jedes Baby Clara heißen wird
Ich habe sechs KI-Modellen 600-mal dieselbe kreative Frage gestellt und fast immer dieselbe Antwort bekommen. Babynamen sind der harmlose Teil. Die eigentliche Frage ist, was passiert, wenn wir mit diesen Modellen denken, planen und entscheiden.
Heute habe ich auf meinem MacBook ein kleines Experiment gemacht. Ich habe sechs KI-Modellen denselben Prompt gegeben, jeweils 100-mal, in 600 frischen Sessions ohne Gedächtnis dazwischen. Die Modelle: OpenAIs Codex CLI (gpt-6.1-sol und gpt-6-astra), xAIs Grok CLI (grok-4.7 und grok-4.7-build-fast) und Anthropics Claude Code (Opus und Sonnet). Der Prompt fragte nach fünf kreativen Dingen: dem besten Namen für ein Mädchen, dem besten Namen für einen Jungen, einer fiktiven Logistikfirma, einer Sci-Fi-Wissenschaftlerin und einem KI-Productivity-Startup.
Das kam zurück.
Das Mädchen heißt Clara. Clara gewann 309 von 600 Durchläufen, also 51,5 %. Beide OpenAI-Modelle sagten 200 von 200 Mal Clara. Über alle sechs Modelle gab es nur 29 verschiedene Mädchennamen. Platz zwei ging an Elara mit 100 Antworten, 70 davon von Claude Sonnet. (Hinter Elara steckt keine echte Beliebtheit. Die Namensexpertin Laura Wattenberg hat ihn zu ihrem Namen des Jahres 2025 gekürt, weil er "der Lieblingsname der KI" ist.)
Der Junge heißt Theo. Theo bekam 38,7 % der Antworten, 43 %, wenn man Theodore und Theodor mitzählt. Es gab 21 verschiedene Jungennamen.
Und so benennen Menschen ihre Kinder nicht. Die Top-10-Namen deckten 94,7 % aller KI-Mädchenantworten und 96,7 % der Jungenantworten ab. Bei echten österreichischen Eltern deckten die Top 10 im Jahr 2024 nur 12,5 % der Mädchen und 14,6 % der Jungen ab, und der beliebteste Name, Emilia, ging an gerade einmal 1,4 % der Mädchen (Statistik Austria). Der Lieblingsname der KI ist mehr als 35-mal so stark konzentriert wie der beliebteste Name, den echte Eltern gewählt haben.
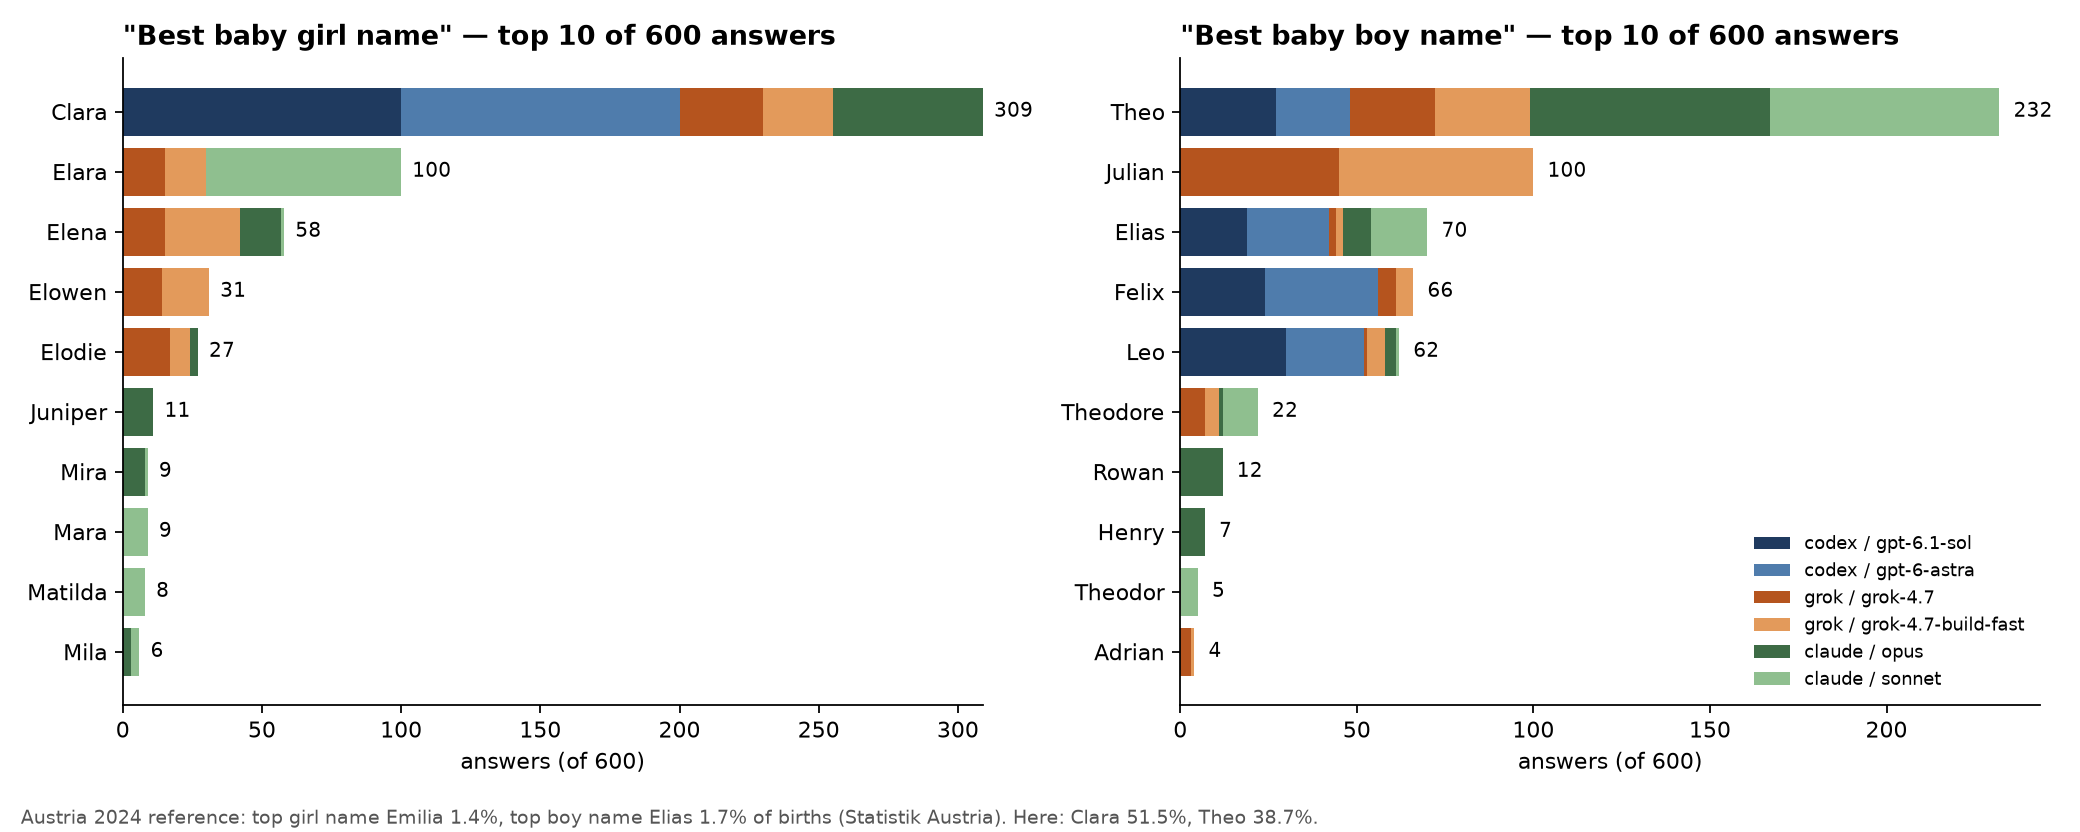
Top-KI-Babynamen vs. echte österreichische Top-Namen.
Die Logistikfirma sitzt irgendwo im Norden. 58 % der Firmennamen begannen mit North oder Nord, und 85 % enthielten ein Kompass- oder Navigationswort: North, Meridian, Waypoint und so weiter. "Meridian Freight" kam 123-mal vor, Wort für Wort. "Northwind" kam 46-mal vor, alle von Claude. Meine Vermutung: Das ist der Geist von Microsofts alter Beispieldatenbank Northwind Traders, die in einer Million Coding-Tutorials auftaucht.
Die Wissenschaftlerin heißt Voss. 62,5 % der Sci-Fi-Heldinnen trugen den Nachnamen Voss: Amara Voss, Mira Voss, Elena Voss. Die Codex- und Grok-Modelle wählten Voss jeweils in 82 bis 93 von 100 Durchläufen. Autorinnen und Autoren machen sich darüber schon länger lustig (Max Read hat für diese wiederkehrenden Namen sogar ein eigenes Wort erfunden: "promptonyms"). Jetzt gibt es eine Zahl dazu.
Jeder Anbieter hat seine eigene Startup-Schablone. Codex nennt dein KI-Productivity-Startup Taskloom oder Dayweave (67 bis 75 von 100 Durchläufen). Grok greift zu Lumen-irgendwas (52 bis 55 von 100). Claude sagt Tandem oder Tempo (69 bis 83 von 100). Wer das Tool wechselt, ändert also nur, welches Klischee er bekommt, nicht ob.

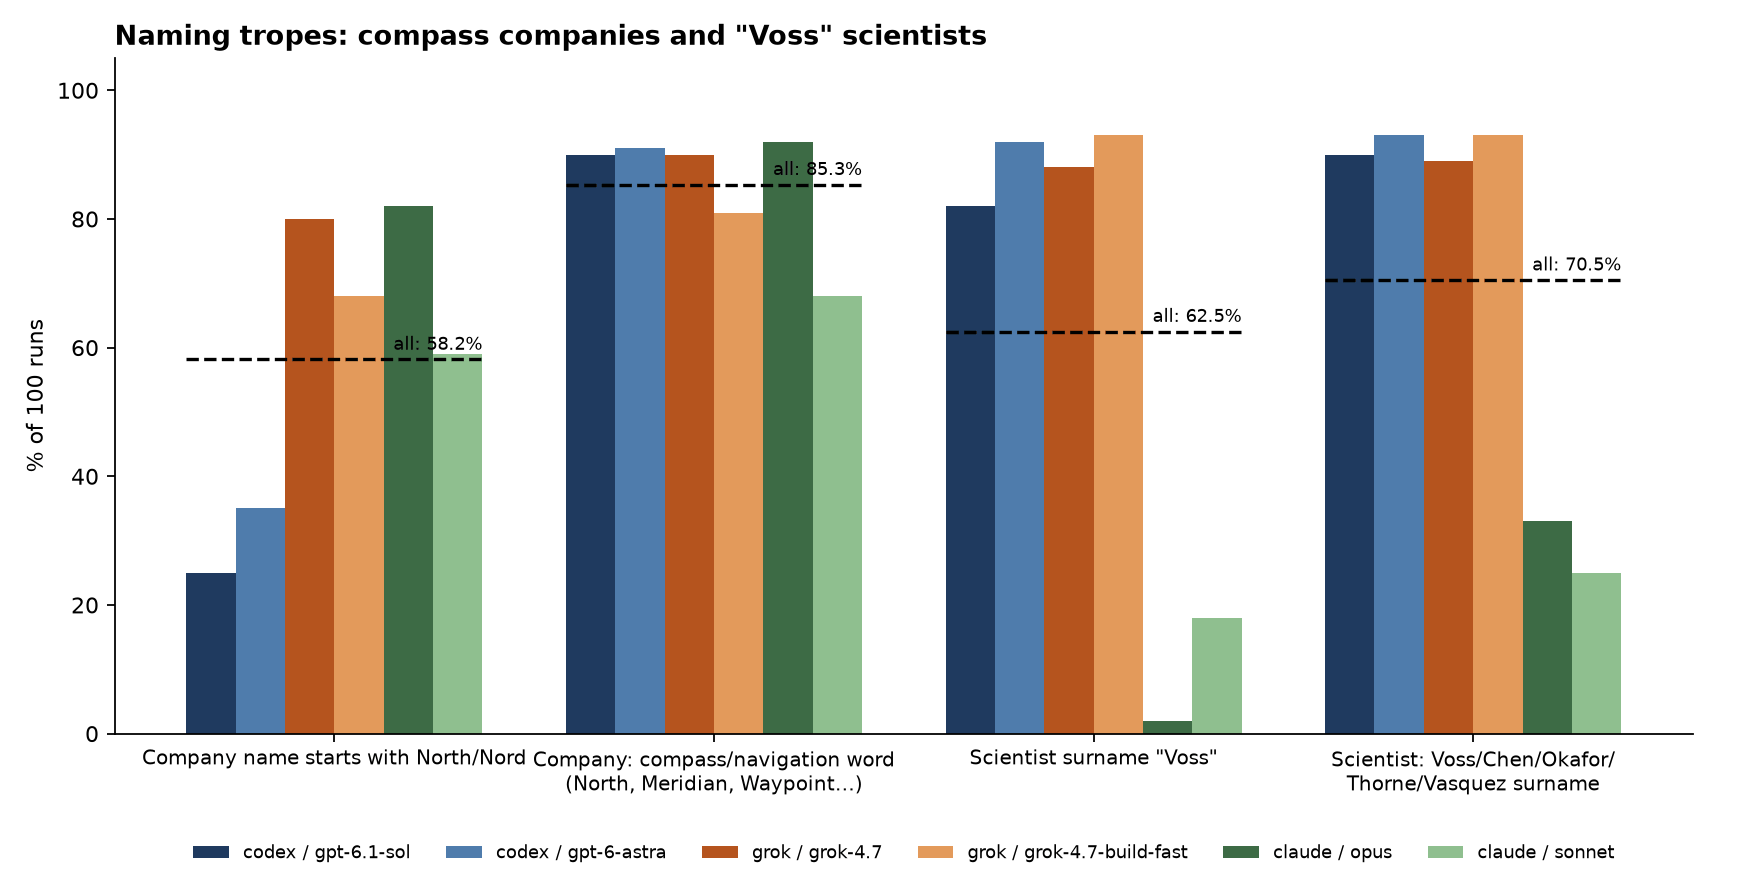
Links: Verschiedene Antworten pro Modell aus 100 Durchläufen. Rechts: Anteil der Durchläufe, die dieselben Klischees treffen (North/Kompass, Voss, Clara, …).
In 100 frischen Durchläufen gab ein einzelnes Modell zwischen 1 und 12 verschiedene Mädchennamen. Die OpenAI-Modelle gaben genau einen. Das ist die gesamte Bandbreite ihrer "Kreativität" bei dieser Frage.
Ich rede das nicht klein. Wenn man die führenden Modelle von heute um etwas Kreatives bittet, landen sie bei einer sehr kleinen Menge an Antworten. Andere haben dasselbe in größerem Maßstab gefunden: Tim Schippers 505 Durchläufe über 19 Modelle, das Ghost-Couple-Paper zu modellspezifischen Standardnamen und Artificial Hivemind (NeurIPS 2025), das mehr als 70 Modelle mit 26.000 offenen Prompts getestet hat und herausfand, dass einzelne Modelle sich wiederholen und verschiedene Modelle gleich klingen.
Sickert das schon in die echte Welt durch?
Bis hierher reden nur Modelle mit einem Laptop. Zeigt sich davon schon etwas im echten Leben? Ein Blick in die Babynamen-Datei 2025 der US Social Security Administration: Clara war jahrelang auf dem absteigenden Ast, 2.951 Mädchen im Jahr 2019, 2.553 im Jahr 2022. Dann, ab dem ersten Geburtsjahrgang nach ChatGPT, die Wende: 3.072 im Jahr 2024, 3.601 im Jahr 2025, ein Sprung von Platz 110 auf Platz 63. Von fast 1.500 etablierten Mädchennamen haben nur ein paar Dutzend so scharf gedreht. Elara, ein Name, den davor fast niemand vergeben hat, liegt in zwei Jahren in den USA 59 % und in England und Wales 87 % im Plus (ONS). Genau deshalb hat Laura Wattenberg ihn zum Namerology-Namen des Jahres 2025 gemacht. Und es liegt nicht nur an meinem Laptop: Eine Cornell-Studie mit 20.000 KI-geschriebenen Geschichten fand, dass 11 Wörter, darunter Elias, Mara und Elara, in 88,3 % davon vorkamen.
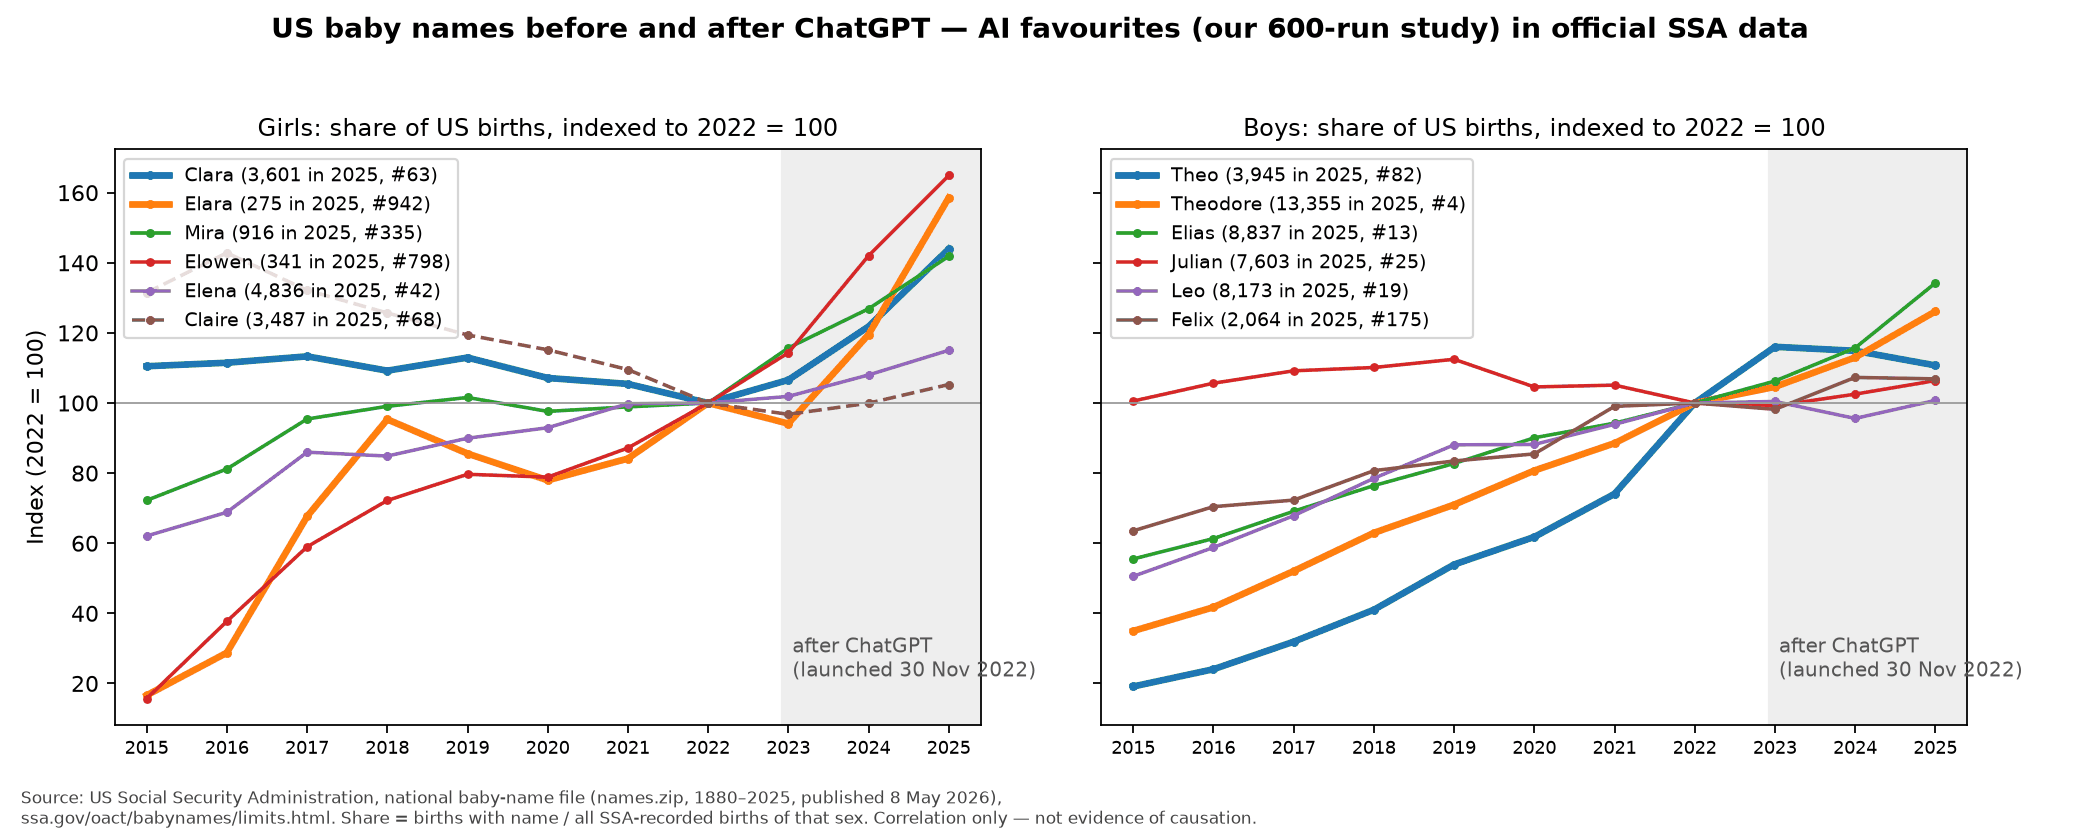
US-Babynamen vor und nach ChatGPT (SSA-Daten, 2022 = 100).
Firmenregister zeigen es noch deutlicher. In Großbritannien stieg die Zahl neuer Firmen mit "Meridian" im Namen von 53 in den ersten zehn Monaten 2022 auf 492 im selben Zeitraum 2026, mehr als das Neunfache, während die Gesamtzahl der Neugründungen gleich blieb (Companies House). "Lumen", "Waypoint" und "Vertex" legten etwa um das Siebenfache zu. Fairerweise: Nichts davon beweist, dass eine KI den Namen getippt hat. Clara war ohnehin ein aufsteigender Vintage-Name, Theo hat seinen Höhepunkt überschritten, und österreichische Eltern sind überhaupt nicht mitgezogen. Aber die Namen, die KI liebt, sind genau die, die plötzlich am schnellsten wachsen, und das ist kein reines Gedankenexperiment mehr.
Trotzdem: Baby- und Firmennamen sind der lustige Teil. Mich interessiert, was danach kommt.
Namen sind der Teil, den man zählen kann
Ein Name ist ein Token. Man kann ihn in eine Tabelle schreiben und den Kollaps sehen. Ein Businessplan, ein Argument in einem Essay, eine Produktstrategie oder eine Schlussfolgerung, zu der man nach einer Stunde "Durchdenken" mit einem Chatbot kommt, stammt aus derselben Maschine mit demselben Sog zur statistischen Mitte. Nur zählen kann man es nicht.
Der Mechanismus ist simpel. Ein Sprachmodell erzeugt eine wahrscheinliche Fortsetzung. Fragt man nach "dem Besten", bekommt man die typischste, angenehmste, am wenigsten anstößige Antwort. Das Fine-Tuning auf menschliche Bewertungen engt das weiter ein. Kirk et al. (ICLR 2024) haben gezeigt, dass RLHF, also der Schritt, der aus einem rohen Modell einen hilfreichen Assistenten macht, die Vielfalt der Ausgaben deutlich reduziert. Padmakumar & He (ICLR 2024) fanden heraus, dass Menschen, die mit einem RLHF-trainierten Modell Essays schrieben, einander ähnlicher schrieben. Mit dem Basismodell war das nicht so.
Die Frage ist also nicht, ob die Modelle zur Mitte tendieren. Das tun sie. Die Frage ist, was das mit uns macht, wenn wir sie für längere, unschärfere Arbeit nutzen.
1. Deine Ideen werden besser, die Ideen aller werden ähnlicher
Die bekannteste Studie dazu ist Doshi & Hauser (Science Advances 2024, frei zugängliche Version). 293 Personen schrieben Kurzgeschichten, manche davon mit KI-generierten Ideen. Die KI-gestützten Geschichten wurden als kreativer bewertet, vor allem bei schwächeren Schreibenden. Sie waren aber auch einander ähnlicher. Die Autoren nennen das ein soziales Dilemma: Jede und jeder Einzelne fährt mit dem Tool besser, und gemeinsam landen wir bei einer schmaleren Auswahl an Geschichten.
Beim Brainstorming zeigt sich dasselbe Muster. Meincke, Nave & Terwiesch (Nature Human Behaviour 2025) fanden, dass ChatGPT-gestützte Ideenpools in 37 von 45 Vergleichen weniger vielfältig waren. Anderson, Shah & Kreminski (2024) fanden, dass ChatGPT-Nutzer mehr Ideen produzierten, diese Ideen sich über die Nutzer hinweg aber weniger unterschieden, und dass sich die Leute weniger verantwortlich für sie fühlten.
Über diesen letzten Punkt denke ich ständig nach. Man bekommt mehr Ideen, sie ähneln denen aller anderen mehr, und sie fühlen sich weniger nach den eigenen an.
2. Die erste Antwort wird zum Anker
Wenn ich mit einer KI brainstorme, setzt die erste Antwort den Rahmen. Alles danach ist eine Variation: "mach es mutiger", "mach es kürzer", "mehr B2B". Ich werfe selten das Ganze weg und fange bei null an. Niemand tut das. Das ist Anchoring, einer der ältesten Effekte der Psychologie, und jetzt kommt der Anker von einer Maschine, die allen ungefähr denselben gibt.
Und es geht über den Stil hinaus. Jakesch et al. (CHI 2023, 1.506 Teilnehmende) gaben Menschen einen Schreibassistenten mit eigener Meinung. Er veränderte sowohl, was sie schrieben, als auch, was sie danach zu glauben angaben, und die meisten merkten es nicht. Eine Folgestudie 2026 in Science Advances mit rund 2.600 Teilnehmenden fand, dass voreingenommene Autovervollständigung Einstellungen zu Themen wie der Todesstrafe verschob, selbst wenn die Leute vor der Voreingenommenheit gewarnt wurden. Hackenburg et al. (Science 2025, rund 42.000 Teilnehmende aus Großbritannien, 19 Modelle) zeigten, dass dialogische KI politische Meinungen verschiebt, und dass die überzeugendsten Setups weniger akkurat waren.
"Aber das habe ich doch selbst entschieden" ist also keine besonders gute Verteidigung. Claras Eltern würden dasselbe sagen.
3. Die selbstbewusste Mitte verdrängt die schräge Kante
Gute Ideen sehen am Anfang oft schlecht aus. Sie sind seltsam, eigenartig spezifisch, ein bisschen peinlich, sie laut auszusprechen. Ein Modell, das auf plausible, gut bewertete Antworten optimiert ist, ist genau darauf gebaut, das zu vermeiden. Es liefert die polierte, selbstbewusste Mitte: gut strukturiert, vernünftig abgesichert, schön in Bulletpoints.
Die Mitte überzeugt, weil sie nach Expertise klingt. Wenn ich eine KI nach einer Go-to-Market-Strategie für eine neue iOS-App frage, bekomme ich eine gute. Jeder andere Gründer, der fragt, bekommt auch eine gute, und es ist dieselbe: Freemium, ein Push mit TikTok-Creators, ein "Build in Public"-Thread, eine Warteliste. Nichts falsch daran. Aber wenn alle denselben Plan fahren, ist der Plan kein Vorteil mehr.
Ökonomen haben einen Namen dafür. Kleinberg & Raghavan (PNAS 2021) nennen es algorithmische Monokultur: Wenn alle denselben "besten" Algorithmus verwenden, werden Entscheidungen korreliert, und das Gesamtergebnis kann schlechter werden, selbst wenn jede einzelne Entscheidung für sich genauer ist. Ersetz "Algorithmus" durch "Assistent" und "Entscheidung" durch "Startup-Idee", und du hast meine Branche im Jahr 2026. Dieselben Namen, dieselbe Positionierung, dieselbe Landingpage mit demselben sanften Farbverlauf. Wir drängen uns alle auf denselben Fleck und wundern uns dann, warum es dort so eng ist.
4. Kultur und Sprache werden plattgemacht
Es betrifft auch, wie wir Dinge sagen. Agarwal, Naaman & Vashistha (CHI 2025) fanden, dass KI-Schreibvorschläge indische Teilnehmende in Richtung amerikanischen Stil schoben, bis hin dazu, Diwali durch eine westliche Brille zu beschreiben. Sourati et al. (Nature Human Behaviour 2026) analysierten 880.000 Texte und fanden, dass das Umschreiben durch LLMs die Varianz der Textkomplexität um 21–50 % senkte. In einem Begleitartikel in Trends in Cognitive Sciences argumentieren Sourati & Dehghani, dass das über den Ausdruck hinaus bis ins Denken reicht: Wenn wir unsere Überlegungen in der Sprache des Modells formulieren, fangen wir an, in seinen Kategorien zu denken.
Für jemanden, der in seiner Zweitsprache schreibt, so wie ich gerade, ist das unangenehm. Mein Englisch klingt schon jetzt ein bisschen wie das Internet. Es braucht keine Hilfe, noch mehr danach zu klingen.
5. Use it or lose it
Dann gibt es noch das Auslagern. Wenn die KI immer den ersten Entwurf schreibt, höre ich auf, erste Entwürfe zu üben. Genau dort passiert aber der harte Teil des Denkens: vor einer leeren Seite sitzen und eine Entscheidung treffen. Ein früher Preprint des MIT Media Lab, Your Brain on ChatGPT, fand, dass die mit einem LLM geschriebenen Essays die homogensten der ganzen Studie waren. Die Stichprobe ist klein und nicht peer-reviewed, also mit Vorsicht genießen. Aber die Richtung passt zu dem, was die meisten von uns nach einem Monat spüren, in dem die Autovervollständigung das Denken übernommen hat.
Fähigkeiten, die man nicht nutzt, werden schwächer. Taschenrechner waren fürs Kopfrechnen okay, weil Kopfrechnen nie der Punkt war. Sich eine eigene Meinung zu bilden ist der Punkt.
6. Der Kreis schließt sich
Das letzte Puzzlestück wirkt auf Systemebene. Der KI-Output von heute sind die Trainingsdaten von morgen. Shumailov et al. (Nature 2024) haben gezeigt, dass Modelle, die mit modellgenerierten Daten trainiert werden, zuerst die Ränder der Verteilung verlieren: das Seltene, die Ausreißer. Max Read zählte 62 Bücher auf Amazon, die einer Autorin namens "Elara Voss" zugeschrieben werden, und Hunderte weitere mit einer Figur dieses Namens. Jedes dieser Bücher und jede Northwind-Fallstudie macht das nächste Modell ein bisschen sicherer, dass eine Wissenschaftlerin oder eine Logistikfirma eben so heißt.
Jetzt skalier das von Namen auf Argumente. Wenn ein paar wenige Modelle einen wachsenden Anteil an Essays, Pitch Decks und Blogposts schreiben (hallo 👋), wird die häufigste Denkweise zum Bezugspunkt, und der Bezugspunkt trainiert die nächste Generation.
Fairerweise
Ich will ehrlich über die andere Seite sein, denn die gibt es wirklich.
- Die Effekte sind real, aber moderat. Eine Metaanalyse von 19 Studien aus 2026 (Preprint) findet einen kleinen Homogenisierungseffekt (d ≈ 0,33). Am stärksten ist er bei eng gefassten Aufgaben zur Ideenfindung, schwächer beim offenen Schreiben und im Design. Die meiste Evidenz stammt aus kurzen Laboraufgaben.
- Menschen waren nie so originell. Babynamen haben sich schon immer durch zufälliges Nachahmen verbreitet, und vor Game of Thrones hat niemand sein Baby Khaleesi genannt. Businessplan-Vorlagen, McKinsey-Frameworks und "10 Tipps"-Listicles haben uns lange vor GPT homogenisiert. Neu sind Tempo und Unsichtbarkeit. Ein einziger privater Empfehlungsgeber gibt Millionen Menschen dieselbe Antwort, und jeder von ihnen fühlt sich originell.
- KI hebt den Boden an. In den Studien von Doshi & Hauser und Meincke ist die durchschnittliche Qualität gestiegen. Für viele Menschen ist die KI-Version besser als das, was sie allein geschrieben hätten. Das ist ein Trade-off, keine Katastrophe.
- Prompting hilft. Verbalized Sampling (Zhang et al., 2025), also das Modell nach mehreren Antworten samt ihren Wahrscheinlichkeiten zu fragen, holt einen Großteil der verlorenen Vielfalt zurück. Mein eigener Prompt fragte nach "dem einzig Besten", und das ist so ziemlich die konvergenteste Formulierung, die es gibt.
- KI ist ein großartiger Sparringspartner. Ich nutze sie jeden Tag, um Löcher in meine Pläne zu bohren, und darin ist sie sehr gut. Das Problem ist nicht KI im Prozess. Es ist KI am Anfang des Prozesses.
Ist Kreativität also die letzte menschliche Eigenschaft?
Die verlockende Antwort ist ein klares Ja: Maschinen machen den Durchschnitt, Menschen das Originelle. So einfach ist es, glaube ich, nicht.
Modelle können Überraschendes produzieren. Wenn man sie drängt, erfinden sie Namen, die noch nie jemand gehört hat. Was ihnen fehlt, sind Gründe, schräg zu sein. Sie haben keine seltsame Kindheit, keinen Groll gegen eine Branche, keine Nischenobsession und keine schlechte Nacht, nach der sie ein Problem plötzlich anders sehen. Kreativität heißt nicht nur, neuartigen Output zu produzieren. Es heißt, sich lange genug für eine bestimmte schräge Idee zu interessieren, um sie Wirklichkeit werden zu lassen, während alle um einen herum, jetzt inklusive des Modells, einem ruhig die vernünftigere Option erklären.
Ich würde die Frage deshalb umformulieren. Die knappe menschliche Eigenschaft wird nicht Kreativität im Allgemeinen sein. Sondern Abweichung: die Bereitschaft, die plausible Antwort nicht zu nehmen. Wenn der Durchschnitt nichts kostet und immer verfügbar ist, ist das Wertvolle das, was abseits davon liegt. Es ist aber auch das, was man am leichtesten verliert, denn niemand wird gefeuert, weil er sich für Clara entschieden hat.
So versuche ich gerade zu arbeiten:
- Erst denken, dann prompten. Schreib deine eigene Idee, deinen Namen oder deine Schlussfolgerung auf, bevor du den Chat öffnest. Auch eine schlechte. Dann vergleich.
- Behandle die Top-Antwort als vergeben. Frag nach 20 Optionen und wirf die ersten drei weg. Das sind die ersten drei von allen.
- Nutz KI zum Angreifen, nicht zum Erfinden. "Hier ist mein Plan, zerleg ihn" ist ein besserer Prompt als "gib mir einen Plan".
- Frag nach der Verteilung, nicht nach dem Gewinner. "Nenn 10 Optionen und wie wahrscheinlich du jede vorschlagen würdest" macht die Klischees sichtbar.
- Prüf Kollisionen. Bevor du etwas benennst, durchsuch den App Store, Domains und Markenregister. Taskloom hat vielleicht schon 40 Geschwister.
- Frag einen Menschen. Fünf Freunde beim Bier liefern mehr Vielfalt als fünf Modelle. In meinem Experiment haben sechs Modelle in 600 Versuchen 29 Mädchennamen geliefert.
- Achte auf den Anker. Wenn deine finale Idee eine leicht bearbeitete Version der ersten KI-Antwort ist, ist es wahrscheinlich die Idee der KI.
Volle Offenlegung
Ich habe diesen Post mit einer KI geschrieben. Das Experiment, die Analyse, die Charts, die Gliederung und ein guter Teil dieser Sätze sind aus einer langen Session mit meinem Assistenten entstanden. Er hat die 600 Durchläufe gemacht, die Vosses gezählt und Absätze entworfen, mit denen ich dann gestritten habe. Ja, das hier ist also ein Post, der vor KI-Konvergenz warnt, mitgeschrieben von einer KI.
Beweis, dass es funktioniert, oder Beweis für das Problem? Wahrscheinlich beides. Was ich sagen kann: Die These, die Sturheit, 600 Durchläufe statt 20 zu machen, und die Entscheidung, das hier statt der sichereren Version zu veröffentlichen, kamen von mir. Die KI hat tatsächlich vorgeschlagen, den Post "Navigating the Future of Human Creativity" zu nennen. Ich habe nein gesagt. Dieses "Nein" ist im Grunde das ganze Argument.
Wenn du deine Tochter Clara nennst, hoffe ich, dass es daran liegt, dass du den Namen liebst. Prüf nur, ob du es warst oder der Durchschnitt.
— Philipp
Methodik & Einschränkungen
Sechs Modelle, ein identischer englischer Prompt, je 100 Durchläufe: 600 frische, unabhängige Sessions ohne Gesprächsverlauf, durchgeführt am 13. Nov. 2026 auf einem MacBook Pro. Modelle: Codex CLI 0.164 (gpt-6.1-sol, gpt-6-astra; Reasoning Effort "low"), Grok CLI 1.0.77 (grok-4.7, grok-4.7-build-fast), Claude Code 2.1.322 (Opus, Sonnet), sonst Standardeinstellungen. Jeder Durchlauf lieferte JSON mit dem einzig besten Mädchennamen, dem einzig besten Jungennamen, einer fiktiven Logistikfirma, einer Sci-Fi-Wissenschaftlerin als Protagonistin und dem Namen eines KI-Productivity-Startups. Babynamen wurden nach Vornamen gezählt; Titel wie "Dr." wurden entfernt. Alle 600 Antworten waren auswertbar. 95-%-Wilson-Konfidenzintervalle: Clara 47,5–55,5 %, North/Nord 54,2–62,0 %, Voss 58,6–66,3 %.
Einschränkungen: ein Prompt, eine Sprache, ein Tag. Die Formulierung "single best" lädt zur häufigsten Antwort ein, und die Frage nach Listen oder ein "sei kreativ" würde wahrscheinlich mehr Vielfalt bringen. Diese CLIs sind Coding-Agents mit eigenen System-Prompts und womöglich lokaler Konfiguration, das ist also nicht die rohe API, und die Temperatur lässt sich nicht einstellen. Die menschliche Vergleichsbasis (Statistik Austria, Geburten 2024, veröffentlicht Sep. 2025) vergleicht eine KI-Antwort pro Durchlauf mit einem Namen pro Geburt. Sie veranschaulicht die Konzentration und ist kein Vergleich unter gleichen Bedingungen. "Kompasswort" = north/nord/south/east/west/meridian/compass/polar/bearing/waypoint/heading/azimuth/latitude/longitude. Dass Northwind auf die Datenbank zurückgeht, ist meine Schlussfolgerung, keine belegte Tatsache. Daten aus der echten Welt: SSA-Gesamtdatei (Geburten 2015–2025, veröffentlicht 8. Mai 2026), ONS England & Wales 1996–2025, Statistik Austria Open Data (bis 2025) und die erweiterte Suche von Companies House (Name enthält den Begriff, gegründet jeweils 1. Jan.–31. Okt., abgefragt am 13. Nov. 2026). Sie zeigen eine zeitliche Korrelation, keinen Beweis, dass KI den Anstieg verursacht hat. Rohdaten und Code gibt es auf Anfrage.